Forschung · Masterarbeit
Adversarial Text-to-Image Generation using Contrastive Learning
Caltech-UCSD Birds-200-2011 (CUB-200-2011) · 200 Arten · 11.788 Bilder · 10 Beschreibungen pro Bild
Mai 2022M.Sc. Data Science & Künstliche Intelligenz, Universität des Saarlandes
Über das Projekt
Bei der Text-zu-Bild-Generierung mit einem generativen gegnerischen Netzwerk (Generative Adversarial Network, GAN) gab es eine Schwäche: Menschen beschreiben denselben Vogel mit sehr unterschiedlichen Worten, und das Modell zeichnete dafür unterschiedliche Vögel. Ich habe das Semantic-Spatial Aware Generative Adversarial Network (SSA-GAN) um kontrastives Lernen (Contrastive Learning, CL) erweitert, sodass Beschreibungen desselben Bildes zusammengezogen und Beschreibungen verschiedener Bilder auseinandergeschoben werden, sowohl beim Vortraining der Text- und Bild-Encoder als auch beim Training des Generators.
Das Modell ist in Python mit PyTorch geschrieben: ein bidirektionaler Long Short-Term Memory (LSTM)-Text-Encoder und ein Inception-v3-Bild-Encoder, zusammen das Deep Attentional Multimodal Similarity Model (DAMSM), mit einem kontrastiven Loss vortrainiert. Ein SSA-GAN-Generator nutzt Masken-Prädiktoren, die entscheiden, wo im Bild welcher Teil der Beschreibung gilt. Trainiert wurde 600 Epochen lang auf dem Caltech-UCSD Birds-200-2011-Datensatz (CUB-200-2011), evaluiert mit Fréchet Inception Distance (FID), Inception Score und R-Precision.
Das Ergebnis hatte den niedrigsten FID aller verglichenen Modelle, 15,10, und hob die R-Precision von 73,55 für das von mir reproduzierte SSA-GAN auf 84,08: Die Bilder wurden realistischer und passten besser zu ihren Beschreibungen. Code und trainierte Modelle sind öffentlich.
Was es besonders macht
Die realistischsten Vögel
Seine Bilder hatten den niedrigsten FID aller verglichenen Modelle: 15,10, wobei niedriger näher an echten Fotos bedeutet.
Bilder, die zum Text passen
Die R-Precision, die misst, ob ein Bild zu seiner Beschreibung passt, stieg von 73,55 für das von mir reproduzierte SSA-GAN auf 84,08.
Eine Neuheit, Stand Mai 2022
Nach unserem Kenntnisstand das erste Modell, das lokal gewichtete Bild- und Textmerkmale gemeinsam mit Contrastive Learning lernt.
Bildbeschreibung
„kleiner Vogel, roter Kopf, schwarze Flügel“
Text-Encoder
gemeinsam trainiert
SSA-GAN
+ semantischer Masken-Prädiktor
Bild
passt zur Beschreibung
Contrastive Loss zieht passende Paare aus Beschreibung ↔ Bild zusammen und drückt unpassende auseinander, sodass unterschiedliche Formulierungen derselben Szene dasselbe Bild ergeben.
Drei Probleme, die sie löst
a.Lokale Semantik ignoriert
Conditional Batch Norm behandelte die gesamte Feature Map gleich. SSA-GAN ergänzt einen schwach überwachten Masken-Prädiktor.
b.Eingefrorener Text-Encoder
End-to-End trainiert, sodass der Text-Encoder gemeinsam mit dem Generator gemeinsame Text-Bild-Repräsentationen lernt.
c.Unterschiedliche Bildbeschreibungen
Menschen beschreiben dasselbe Bild mit unterschiedlichen Worten. Contrastive Learning maximiert die Transinformation zwischen Text und Bild.
Daten und Training
- Datensatz
- Caltech-UCSD Birds-200-2011 (CUB-200-2011): 200 Vogelarten, 11.788 Bilder, 10 Beschreibungen pro Bild
- Bildgröße
- 256 × 256 Pixel
- Text-Encoder
- Bidirektionales Long Short-Term Memory (LSTM) mit 256-dimensionalen Embeddings
- Bild-Encoder
- Inception-v3, auf ImageNet vortrainiert; beide Encoder bilden zusammen das Deep Attentional Multimodal Similarity Model (DAMSM)
- Kontrastiver Loss
- Normalized Temperature-scaled Cross Entropy (NT-Xent), Temperatur 0,5, übrige Paare im Batch als Negativbeispiele
- Adversarialer Loss
- Hinge Loss
- Optimierer
- Adam: Generator 0,0001, Diskriminator 0,0004, Betas (0,0, 0,9)
- Training
- Batchgröße 24, 600 Epochen auf einer GPU; evaluiert wird das Modell aus Epoche 550
- Metriken
- Fréchet Inception Distance (FID; Realismus, niedriger ist besser), Inception Score (Qualität und Vielfalt), R-Precision (Bild passt zur Beschreibung)
Ergebnisse auf CUB-Vögeln
Mein Modell im Vergleich mit veröffentlichten Text-zu-Bild-Modellen. Der Fréchet Inception Distance (FID) misst Realismus (niedriger ist besser), der Inception Score Qualität und Vielfalt und die R-Precision, wie gut ein Bild zu seiner Beschreibung passt.
| Modell | Inception Score ↑ | FID ↓ | R-Precision ↑ |
|---|---|---|---|
| StackGAN++ | 4,04 ± 0,06 | 15,30 | – |
| AttnGAN | 4,36 ± 0,03 | 23,98 | 67,82 ± 4,43 |
| AttnGAN + CL | 4,42 ± 0,05 | 16,34 | 69,64 ± 0,63 |
| ControlGAN | 4,58 ± 0,09 | – | – |
| SD-GAN | 4,67 ± 0,09 | – | – |
| DM-GAN | 4,75 ± 0,07 | 16,09 | – |
| DM-GAN + CL | 4,77 ± 0,05 | 14,38 | 78,99 ± 0,66 |
| DF-GAN | 4,86 ± 0,04 | 19,24 | – |
| SSA-GAN * | 5,17 ± 0,08 | 15,61 | 86,70 ± 0,91 |
| SSA-GAN # | 5,13 ± 0,06 | 15,60 | 73,55 ± 0,68 |
| SSA-GAN + CL (meins) | 4,85 ± 0,08 | 15,10 | 84,08 ± 0,73 |
* wie im SSA-GAN-Paper veröffentlicht. # SSA-GAN, von mir mit demselben Aufbau reproduziert. Mein Modell hat den niedrigsten FID der Tabelle und hebt die R-Precision um 10,5 Punkte gegenüber dem reproduzierten SSA-GAN; sein Inception Score liegt unter dem von SSA-GAN.
Screenshots
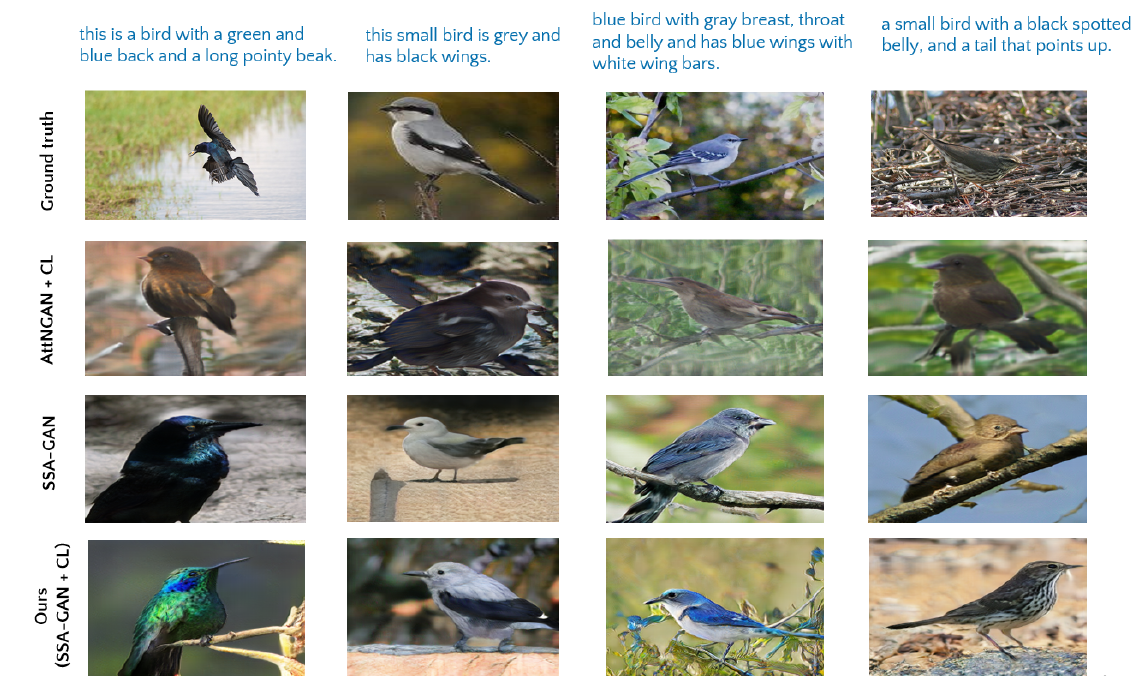
Abbildungen aus der Masterarbeit: Vögel, erzeugt aus Beschreibungen des CUB-Testsets, und die Ergebnistabelle.
Erzeugte Vögel
Vier Beschreibungen, das echte Foto und die Vögel von AttnGAN + CL, SSA-GAN und meinem Modell.
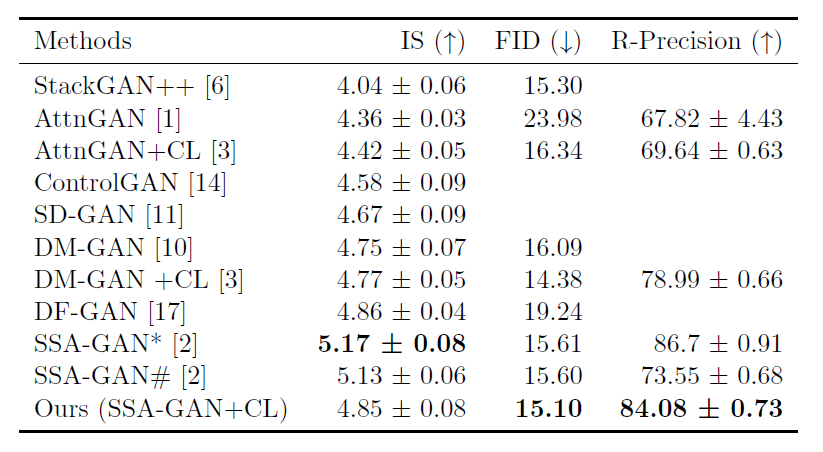
Ergebnistabelle aus der Masterarbeit
Inception Score, FID und R-Precision im Vergleich mit veröffentlichten Modellen auf CUB-Vögeln.
Herausforderungen und Gelerntes
Herausforderung: Menschen beschreiben denselben Vogel mit sehr unterschiedlichen Worten, und das Modell zeichnete für jede Formulierung einen anderen Vogel.
Lösung: Ein Contrastive Loss zieht Beschreibungen desselben Bildes zusammen und schiebt Beschreibungen verschiedener Bilder auseinander, zuerst beim Vortraining der Text- und Bild-Encoder, dann beim Training des Generators.
Gelernt: Metriken ziehen in verschiedene Richtungen: Realismus (FID) und Passung zur Beschreibung (R-Precision) wurden besser, der Inception Score sank leicht. Alle drei zu berichten und die Vergleichsbasis selbst zu reproduzieren, statt nur ihr Paper zu zitieren, hielt den Vergleich ehrlich.
Eingesetzte Technologien
Framework ·Python und PyTorch
- Das ganze Modell: Generator, Diskriminator, Text- und Bild-Encoder, eigene Loss-Funktionen und Trainingsschleifen.
Modell ·Semantic-Spatial Aware Generative Adversarial Network (SSA-GAN)
- Semantisch gesteuerte Blöcke mit einem Masken-Prädiktor pro Stufe, der entscheidet, wo im Bild welcher Teil der Beschreibung gilt.
- Erzeugt Bilder mit 256 × 256 Pixeln.
Modell ·Deep Attentional Multimodal Similarity Model (DAMSM)
- Ein bidirektionales Long Short-Term Memory (LSTM) für die Beschreibung und Inception-v3, auf ImageNet vortrainiert, für das Bild.
- Erneut mit einem kontrastiven Loss vortrainiert, damit Beschreibungen desselben Bildes nah beieinander liegen.
Lernen ·Kontrastives Lernen (Contrastive Learning, CL), Normalized Temperature-scaled Cross Entropy (NT-Xent)
- Ein Loss im Stil von SimCLR mit Temperatur 0,5 und den übrigen Paaren im Batch als Negativbeispiele.
- Zweimal eingesetzt: beim Vortraining der Encoder und beim Training des Generators.
Lernen ·Adversariales Training
- Hinge Loss; Adam mit einer Lernrate von 0,0001 für den Generator und 0,0004 für den Diskriminator.
Daten ·Caltech-UCSD Birds-200-2011 (CUB-200-2011)
- 200 Vogelarten, 11.788 Bilder, 10 Beschreibungen pro Bild.
Evaluierung ·Fréchet Inception Distance (FID), Inception Score und R-Precision
- FID für Realismus, Inception Score für Qualität und Vielfalt, R-Precision dafür, wie gut ein Bild zu seiner Beschreibung passt.
Tools ·CUDA und tensorboardX
- GPU-Training über 600 Epochen mit Batchgröße 24; Losses und Beispielbilder in TensorBoard verfolgt.
Mehr erfahren?
Ich zeige Ihnen gern die Produkt- und Engineering-Entscheidungen in einem Call. Lassen Sie uns sprechen.